使用深度学习方法求解高维抛物型偏微分方程通常在计算和内存上开销巨大,这主要是因为在偏微分方程中需要利用自动微分来计算大型海森矩阵。在本工作中,中国科学院大学周涛博导团队联合南卫理公会大学Wei Cai提出了一种深度随机差分法来解决这些问题,该方法仅使用一阶差分来逼近对流-扩散算子,并通过深度神经网络来逼近解,从而避免了海森矩阵及其他导数的计算。深度随机差分法在伽辽金框架下实现以减少采样方差,并利用随机微分方程探索解空间以捕捉对流-扩散算子的动力学特性。该方法随后被扩展到求解 Hamilton-Jacobi-Bellman 方程,这在无需使用随机演算的情况下,复现了现有的用于偏微分方程的鞅深度学习方法。所提出的方法有两个主要优势:它避免了计算偏微分方程中的导数,并实现了损失函数在时间和空间上的并行计算。此外,本文为拟线性抛物型方程证明了一个严格的误差估计,显示出关于时间步长 h 的一阶精度,其中 h 是使用欧拉-丸山格式离散化随机微分方程路径时使用的时间步长。数值实验表明,该方法能够高效且准确地求解维度分别高达 10^5 和 10^4 的拟线性抛物型偏微分方程和 Hamilton-Jacobi-Bellman 方程。

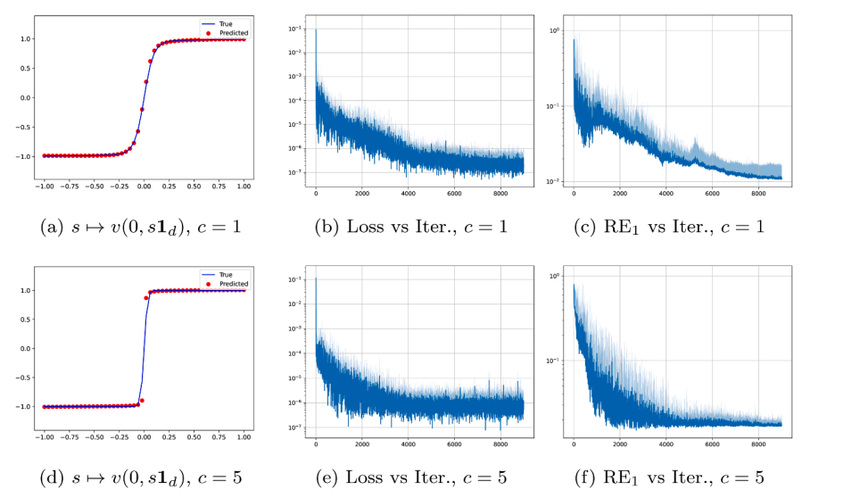
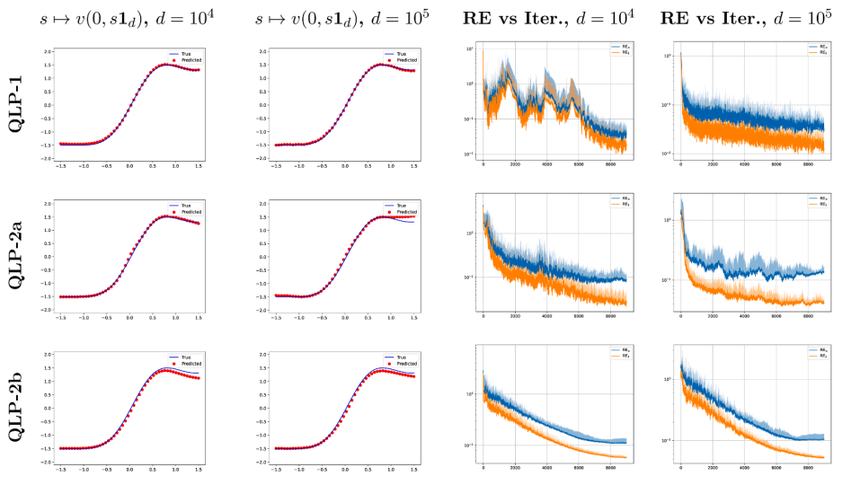
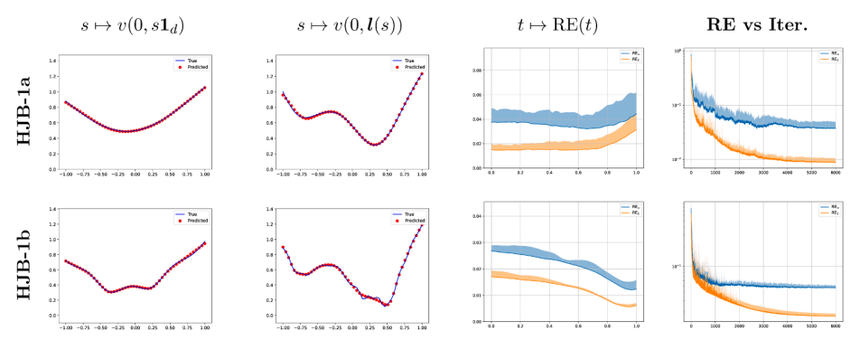
研究成果以“Deep random difference method for high-dimensional quasilinear parabolic partial differential equations”为题发表于期刊Journal of Computational Physics。第一作者为:南卫理公会大学Wei Cai。高维抛物型PDE(如Allen-Cahn方程、Black-Scholes方程、HJB方程等)在金融、物理、工程等领域有广泛应用,但传统数值方法受限于“维数灾难”,计算成本随维度指数增长。深度学习方法(如PINN、DGM)为克服维数灾难提供了新途径,但在处理高维问题时,自动微分(AD)计算Hessian矩阵成为计算和内存瓶颈,尤其对于二阶项(如扩散项)需存储和计算大规模张量。直接法(如PINN):需计算PDE中所有导数项,AD成本高;基于SDE的方法(如DeepBSDE):通过FBSDE转化避免AD,但时间维度难以并行,计算效率受限。亟需一种兼顾并行性与低计算成本的方法,同时保持精度并适用于高维非线性问题。避免AD计算Hessian矩阵的高昂成本,尤其是对于二阶扩散项。提高时间维度的并行性,避免基于SDE方法的时间序列依赖性。在保证精度的同时,处理高维(10^5维)拟线性抛物型PDE及HJB方程。对于一个包含时间导数、一阶空间导数和二阶扩散项的偏微分方程,传统方法需要计算函数关于空间变量的二阶导数(海森矩阵),这在高维情况下计算量和内存消耗巨大。DRDM 引入一个随机向量,满足零均值、单位协方差、三阶矩为零、四阶矩有限等条件,例如标准正态分布。利用这个随机向量,构造一个随机差分算子:在给定的时空点,取一个小的时间步长,将下一时刻的空间点用当前点的漂移项乘以步长加上扩散项乘以步长的平方根再乘以随机向量来扰动。然后计算扰动点上的函数值与当前点函数值的差,除以步长,再对随机向量取期望。通过泰勒展开可以证明,这个期望值与原方程中的微分算子相差一个与步长同阶的小量,即一阶精度逼近。关键在于,这个近似只用到函数在若干随机点上的值,完全不需要计算导数,从而避免了自动微分。将上述随机差分近似代入原方程,得到一个残差形式:期望的残差等于步长的高阶小量。为了在神经网络训练中利用这个关系,采用 Galerkin 方法,引入一个测试函数空间(也用神经网络表示)。构造一个损失函数,它是在整个时间空间区域上对测试函数与残差的乘积取期望再积分。这个损失函数是一个关于解网络和测试网络的函数。然后,将求解原问题转化为一个极小极大问题:解网络希望最小化这个损失函数,而测试网络希望最大化它。这种对抗训练方式使得期望只需在整个时空域上估计一次,大大降低了 mini-batch 估计的方差,同时允许在时间和空间两个维度上并行计算,提高了训练效率。训练过程中,空间样本点的选取对效果至关重要。DRDM 不是随机均匀采样,而是利用原问题本身的动力学生成样本点:从一个初始点出发,按照漂移项和扩散项加上随机扰动进行递推,得到一系列样本路径。这一过程的分布恰好对应于原算子的伴随方程(福克-普朗克方程)的解,能够自动将采样点集中在误差传播的关键区域,尤其是对于具有陡峭梯度的问题,可以更有效地捕捉解的结构。对于 Hamilton-Jacobi-Bellman 方程,其中包含一个关于控制变量的极小化运算,DRDM 采用策略迭代的思想。用两个神经网络分别近似值函数和最优控制。每次迭代中,先固定当前的控制网络,将方程中的极小化项用当前控制代入,使方程线性化,然后应用上述随机差分近似和对抗训练更新值函数网络。接着,固定更新后的值函数网络,通过最小化一个简单的平均损失(将测试函数取为常数)来更新控制网络。这样避免了在每个时空点上求解复杂的极小化问题,大幅降低了计算量。论文在适当的正则性条件下,严格证明了随机差分近似的局部截断误差为一阶,并通过稳定性分析得到全局误差界,即整个方法具有一阶时间收敛性。这比基于随机微分方程路径模拟的深度 BSDE 类方法(通常只有半阶精度)更高,为算法的可靠性提供了理论支持。维度规模:成功求解高达10^5维的拟线性抛物型PDE和10^4维的HJB方程。精度:与解析解或参考解相比,相对误差在10^-2~10^-3量级,能准确捕捉陡峭梯度区域。效率:相比PINN和RS-PINN,DRDM在内存和计算时间上显著优势,尤其在高维(d≥10^4)时,PINN因AD内存爆炸无法运行,而DRDM仍可高效计算。并行性:损失函数可在时间和空间维度完全并行,大大缩短训练时间。采样策略有效性:基于动力学的采样比均匀采样更能聚焦于关键区域,提升学习效果。首次提出RDM,用一阶差分近似二阶算子,彻底摆脱AD计算Hessian的瓶颈,同时保持一阶时间精度(高于DeepBSDE的半阶精度)。Galerkin框架下的极小极大损失:将RDM嵌入对抗训练,降低估计方差,提升训练稳定性与效率。从PDE理论出发统一现有方法:证明RDM等价于离散的martingale方法和FBSDE的隐式Euler格式,但推导更简洁、无需随机微积分。基于误差传播的采样策略:通过Fokker-Planck方程引导空间采样,使训练集中于对误差影响大的区域,增强对陡峭梯度问题的适应能力。严格误差估计:给出局部截断误差、稳定性分析和全局误差界,证明一阶收敛性,为方法提供了理论基础。图1:算法1求解d = 10^3的对流扩散方程(66)的数值结果。第二列中的“损失”指的是算法1中的损失函数项,具体形式为 L^T(ν_θ, ρ_θ; A_1) L(ν_θ, ρ_θ; A_2)。第二列和第三列中的阴影区域表示5次独立运行中相对误差的均值加减2倍标准差。图2:算法1在d = 10^4和10^5时,针对第4.2节中QLP-1、QLP-2a和QLP-2b方程的数值结果。第三列和第四列中的阴影区域表示5次独立运行中相对误差的均值加减2倍标准差,所有相对误差均在t = 0处计算。图3:算法2在d = 10^4时,针对第4.3节中HJB-1a和HJB-1b方程的数值结果。第三列和第四列中的阴影区域表示5次独立运行中相对误差的均值加减2倍标准差。第四列中的相对误差是在t = 0处计算的。在本工作中,我们提出了一种用于求解高维拟线性抛物型偏微分方程和 Hamilton-Jacobi-Bellman 方程的深度随机差分法。深度随机差分法仅使用一阶差分来逼近对流-扩散算子,从而避免了显式计算海森矩阵并减少了对自动微分的依赖。通过将深度随机差分法集成在伽辽金框架内,我们显著降低了小批量估计的方差,实现了高效且高度并行的计算。该方法进一步被扩展到 Hamilton-Jacobi-Bellman 方程。我们提供了严格的误差估计,并通过数值实验证明,深度随机差分法能够高效且准确地求解维度分别高达 10^5 和 10^4 的拟线性抛物型偏微分方程和 Hamilton-Jacobi-Bellman 方程。深度随机差分法从一个更接近物理信息神经网络框架且几乎不依赖随机演算的新视角,复现了现有的鞅深度学习方法。我们的方法提供了几个独特的优势:损失函数不需要对任何偏微分方程导数进行自动微分,从而实现高效计算并减少内存使用。损失函数可以在时间和空间上并行计算,进一步提高了效率。样本分布可以根据对流-扩散算子的动力学特性进行调整,增强了方法处理具有复杂解结构问题的能力。深度随机差分法的截断误差在时间上达到一阶精度,这高于基于欧拉-丸山格式路径性质方法的半阶精度。未来的工作将探索深度随机差分法在更具挑战性问题中的应用,包括具有复杂边界的对流扩散方程、提交函数以及更复杂和非凸的随机最优控制问题。
原文链接:
https://doi.org/10.1016/j.jcp.2026.114767