|
西北工业大学李贺军院士团队最新《npj Computational Materials》!西北工业大学李贺军院士、孙佳教授开发了一个机器学习框架,用于预测含稀土元素的高熵碳化物陶瓷(HECCs)的相形成能力,以应对因实验报道的成分有限而导致的数据不平衡挑战。为克服这一限制,我们采用Borderline-SMOTE方法,将含稀土元素的HECCs数据集从18个样本(3个来自文献,15个来自实验合成)扩充至98个样本,从而为模型训练提供了一个更平衡、更具代表性的数据集。该策略不仅缓解了数据稀缺和不平衡带来的负面影响,还显著提高了后续模型训练的可靠性。 此外,我们采用了一种综合性的四步特征选择策略,整合了皮尔逊相关系数、递归特征消除、穷举特征组合和超参数优化。这种系统性的方法能够识别控制相稳定性的关键特征,同时最小化冗余和过拟合风险。机器学习模型的性能通过AUC、F1分数、召回率和G-mean等多个指标进行了严格评估。在所有评估的模型中,随机森林(RF)模型在准确性和泛化能力之间取得了最佳平衡,其在测试集上的AUC、F1分数、召回率和G-mean值分别达到97.36%、95.83%、95.83%和91.13%。 训练有素的RF模型被进一步应用于预测等摩尔比HECCs的相形成能力。我们选择了八个预测不确定性相对较高的成分进行实验合成与相鉴定,并将其结果迭代纳入数据集。这种预测与实验之间的反馈循环提高了模型的可靠性,最终实现了88.89%的实验验证准确率。重要的是,优化后的RF模型被拓展用于探索(HfZrTaScY)、(HfZrTaScLa)和(HfZrTaYLa)体系更广泛的非等摩尔比成分空间,为设计新型HECCs并发现具有定制性能的材料提供了指导。 尽管Borderline-SMOTE有效改善了类别平衡,但它引入的合成数据可能无法完全捕捉真实实验体系的复杂性。未来的工作将聚焦于通过高通量合成进一步扩展数据集、整合基于领域知识的特征,并探索先进的机器学习策略,以进一步提升预测准确性,支持具有定制性能的HECCs的理性设计。
一、研究背景 材料重要性:高熵碳化物陶瓷(HECCs)因其优异的高温强度、抗烧蚀等性能,在航空航天等极端环境应用前景广阔。 开发瓶颈:其巨大的成分空间和复杂的相形成规律,使得传统“试错法”或高成本计算模拟难以高效探索新材料。 ML应用挑战:虽然机器学习(ML)加速材料发现,但HECCs领域存在 “数据稀缺”和“类别不平衡” 两大核心挑战。特别是含稀土元素的HECCs实验数据极少(少数类),与大量已报道的过渡金属基HECCs(多数类)形成严重不平衡,导致常规ML模型偏向预测多数类,对稀有类别的预测性能差。 二、解决的问题 1.数据不平衡问题:解决因含稀土元素HECCs样本过少导致的类别不平衡,防止模型忽视这类重要但稀有的样本。 2.小数据集下的可靠建模:在总体数据量有限(初始仅171个样本)的情况下,构建泛化能力强、不易过拟合的预测模型。 3.关键特征筛选:从众多物理化学描述符中,识别出真正主导HECCs相稳定性的关键特征,提升模型可解释性和效率。 4.预测结果的实验闭环验证:将模型预测与实验合成紧密结合,迭代优化模型,实现从计算预测到实验发现的可靠循环。 三、提出的方法 1.Borderline-SMOTE数据增强:采用Borderline-SMOTE过采样算法,专门针对“边界上的”稀有样本(含Sc, Y, La的HECCs)生成高质量合成数据,将稀有样本从18个扩增至98个,有效平衡了数据集。 2.四步特征选择策略: 相关性筛选:利用皮尔逊相关系数剔除高度冗余的特征。 递归特征消除:基于模型性能迭代剔除最不重要特征。 穷举特征组合:遍历剩余特征的所有组合,寻找最优特征子集。 超参数优化:使用随机搜索对最优模型进行超参数调优。 1.模型比较与选择:系统比较了随机森林(RF)、XGBoost、支持向量机(SVM)等十种算法,最终确定随机森林(RF) 为最佳模型,其在平衡精度与泛化能力上表现最优。 2.主动学习与实验验证循环:模型预测后,特意挑选8个预测不确定性高的组分进行实验合成与表征,并将实验结果反馈至训练集,重新训练模型,通过多次迭代提升模型可靠性和预测准确率。 四、实现的效果 1.模型性能优异:经Borderline-SMOTE平衡和特征选择后,优化的RF模型在测试集上表现卓越:AUC达97.36%, F1分数和召回率达95.83%, G-mean为91.13%。这表明模型对单相(正类)和复相(负类)都具有极强的判别能力。 2.实验验证成功:对18个新组分(含8个高不确定性组分)的实验验证表明,模型初始预测准确率为77.78%。经过主动学习循环迭代后,最终实验验证准确率提升至88.89%,证明了框架的有效性。 3.指导新材料设计:将训练好的RF模型应用于预测 (HfZrTaScY)C、(HfZrTaScLa)C 和 (HfZrTaYLa)C 三个重要体系的非等摩尔成分空间相图,直观揭示了各元素含量对形成单相固溶体的影响规律,为新材料的成分设计提供了直接的理论指导。 五、创新点 1.方法创新:首次将Borderline-SMOTE算法系统引入HECCs的相预测研究,针对性地解决了材料科学中普遍但棘手的小样本、不平衡数据问题,为类似领域提供了可复用的方法论。 2.策略创新:提出了一个 “智能数据增强→系统特征工程→主动实验验证”的完整闭环研究范式。该范式不仅被动地拟合数据,更通过主动学习引导有价值的实验,高效驱动新材料发现。 3.应用创新:聚焦于数据极度稀缺的含稀土元素高熵碳化物体系,拓展了机器学习在陶瓷材料设计的应用边界。所构建的模型不仅能预测已知体系,还能有效探索未知的非等摩尔成分空间,具备较强的实用价值和前瞻性。 总而言之,这项研究通过精巧地融合先进的不平衡学习算法、严谨的特征工程和主动学习循环,成功构建了一个高效、可靠的HECCs相预测机器学习框架,显著加速了面向极端环境应用的新型高熵碳化物陶瓷的探索进程。 研究成果以题为“Machine learning for phase prediction of high entropy carbide ceramics from imbalanced data”发表在期刊《npj Computational Materials》。单位为:西北工业大学、达姆施塔特技术大学。通讯作者为:西北工业大学李贺军院士、孙佳教授。第一作者为:西北工业大学Xuemeng Zhang。 高熵碳化物陶瓷在极端高温应用领域展现出优异性能。机器学习为加速发现新型高熵碳化物陶瓷提供了有效途径,但数据不平衡问题给预测性能带来了挑战。本研究将Borderline-SMOTE算法与机器学习模型相结合以应对此问题。我们通过整合文献数据、实验合成数据以及合成过采样技术,建立了一个包含251个样本的数据集。通过一种四步特征选择策略,筛选出影响相形成的关键特征。我们对十种常见的机器学习模型进行了训练和优化,确定随机森林模型最适合用于预测高熵碳化物陶瓷的相形成能力。研究对八个具有高不确定性的高熵碳化物陶瓷成分进行了实验验证,并将结果反馈至数据集以迭代提升模型准确性。这项工作为预测高熵碳化物陶瓷的相形成,特别是针对小规模或不平衡数据集,提供了一种高效策略,有助于加速新型高熵碳化物陶瓷的设计与可靠预测。
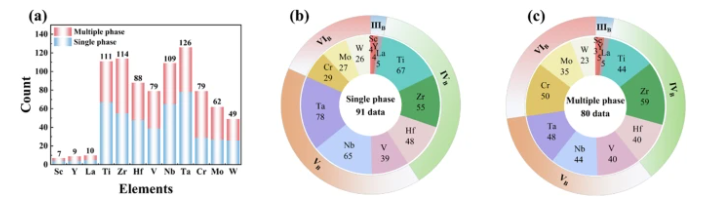
图1:初始数据集的元素分布。a 所有元素的分布,b 单相高熵碳化物陶瓷的元素分布,c 多相碳化物的元素分布。
图2:经Borderline-SMOTE处理后的数据集结构。a Borderline-SMOTE处理前后的数据分布,b 使用t-SNE对原始数据和生成数据进行的数据可视化。  原文链接: |